KurAI.tech
14 agentes de IA que trabajan como un equipo de software, del objetivo de negocio al Pull Request, con modelos locales en Ollama y una sola GPU de 16 GB.
Lo que ves
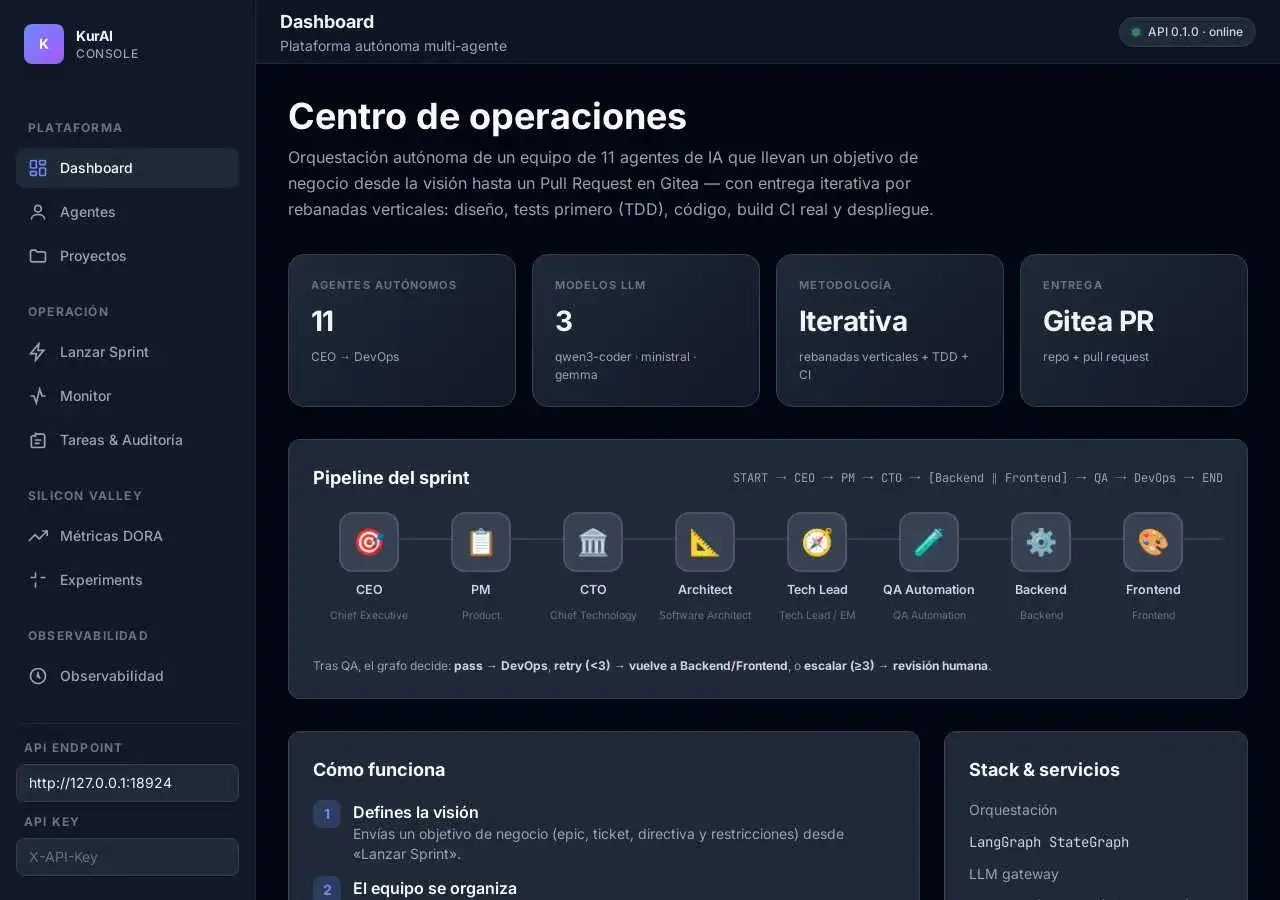
Le das un objetivo de negocio y un equipo entero se pone a trabajar. Un CEO marca la dirección, un Tech Lead corta el trabajo en partes, los desarrolladores escriben primero los tests y un agente de DevOps abre el Pull Request con el código, los tests, las migraciones y el plan de rollback. El video lo cuenta en un minuto, y la consola es desde donde sigo cada sprint.
00:00 / 01:05
Un sprint en un minuto
Del primer comando al Pull Request: así trabajan los agentes de KurAI.tech. El video está en inglés.
Arquitectura
El sistema construye una rebanada vertical a la vez y la integra a un trunk que siempre debe quedar en verde. Lo que más me importa aquí es que cada resultado se pueda medir y que nada de lo que genera un modelo se dé por bueno sin comprobarlo.
Consola y APIFastAPI
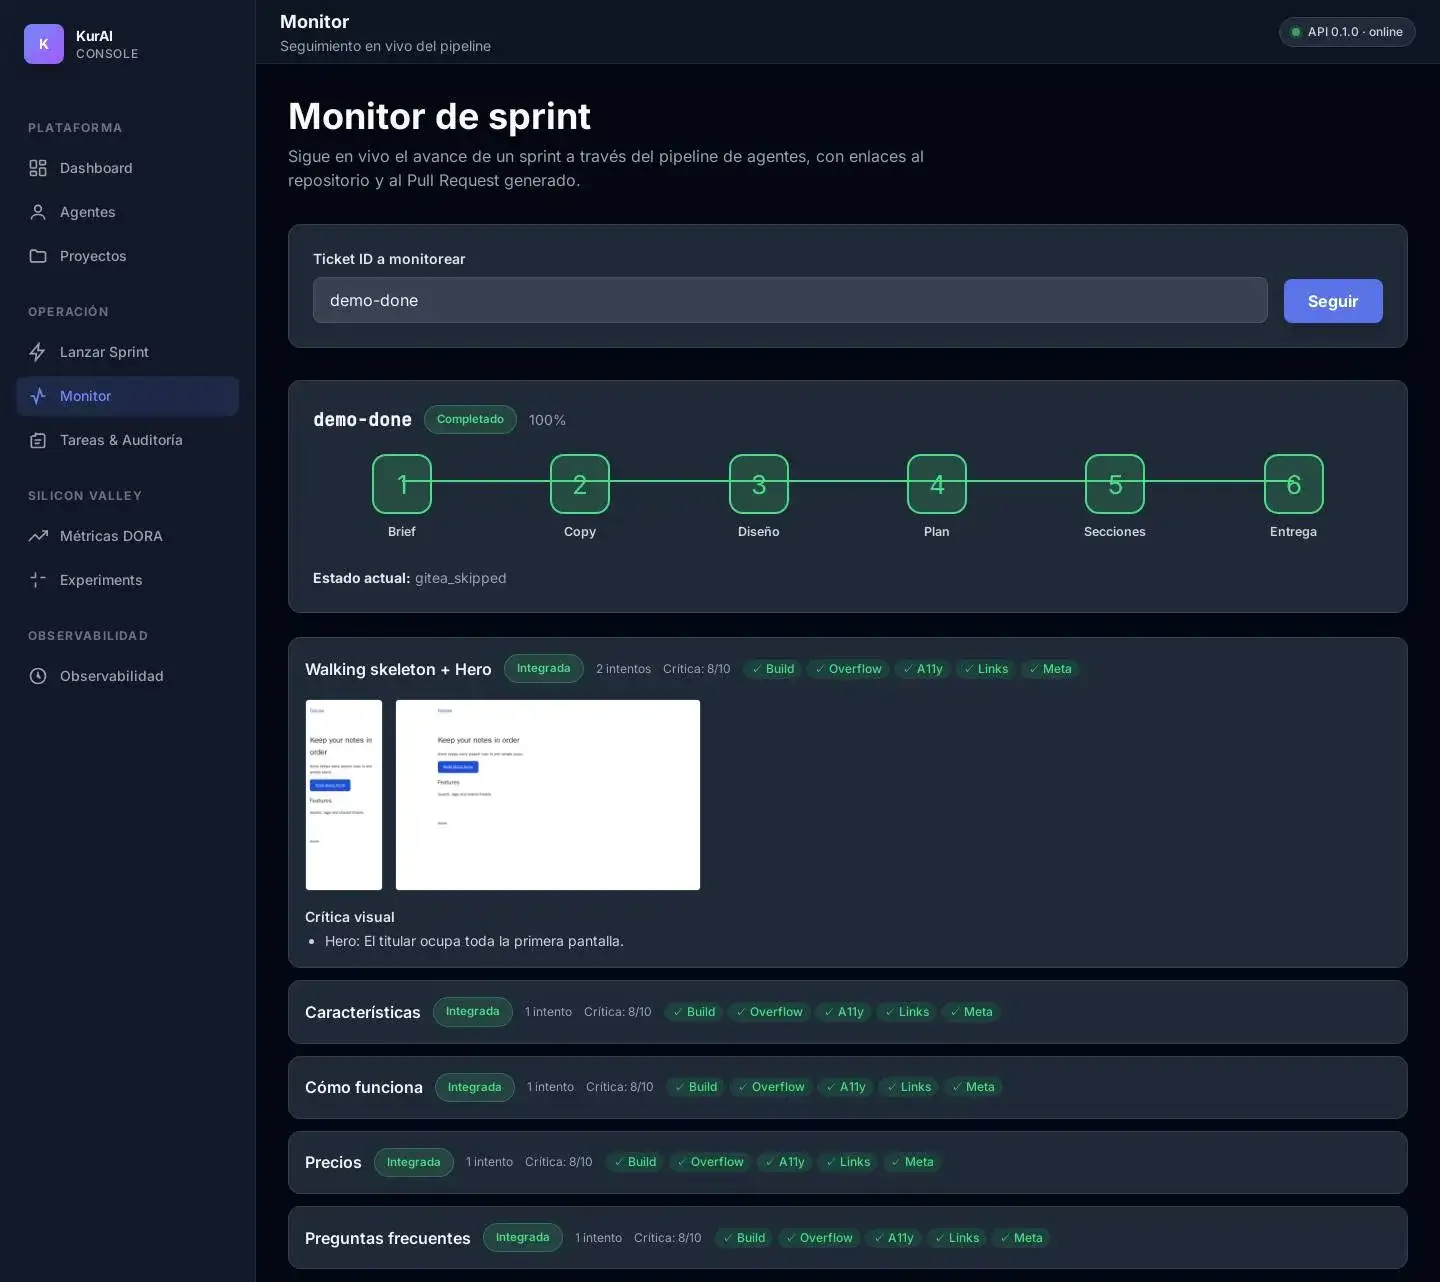
Lanza los sprints, protege la API con una clave y muestra secciones, gates, capturas y resultados mientras el grafo avanza.
SprintWorkflowLangGraph
Ejecuta, reanuda y reporta cada sprint. Los nodos, las decisiones de ruta y el estado compartido viven en módulos separados.
Perfiles del grafolanding · general
Cada perfil es una topología distinta sobre las mismas piezas, así que un flujo nuevo no obliga a reescribir el orquestador.
- OllamaLos modelos, en local
- DockerSandbox y quality gates
- PostgreSQLTareas, auditoría y checkpoints
- QdrantMemoria de los agentes
- GiteaRepositorio y Pull Request
Perfil landing
Hacia donde va el producto, y todavía en desarrollo. Está pensado para construir una landing sección por sección y medir cada una con gates reales. Aún no ha completado un sprint real.
- Brief
- CEO y PM
- Copy y diseño
- Plan de secciones
- Frontend y gates
- Merge al trunk
- Gates finales y PR
Perfil general
El pipeline original, con backend, frontend y pytest. Cada rebanada empieza por sus tests y solo se integra si el build y QA salen en verde.
- Objetivo
- CEO y PM
- CTO y Architect
- Tech Lead
- Tests, backend y frontend
- Integración y QA
- DevOps y PR
Un solo modelo a la vez en 16 GB
Los modelos no caben juntos en la GPU, así que los agentes trabajan por turnos. Cada uno carga su modelo, lo usa y lo descarga con keep_alive en 0. Los roles de razonamiento usan ministral-3:14b, de 9 GB, y los de código usan devstral-small-2, de 15 GB. La memoria usa nomic-embed-text para los embeddings.
Gates que miden de verdad
En el perfil landing, cada sección se compila y se abre en Chromium con las peticiones externas bloqueadas. Se revisa con capturas en 320, 768 y 1280 px, axe, desbordes, enlaces y metadatos, y Lighthouse entra al final. Lo que bloquea vuelve al agente de Frontend como feedback concreto.
Todo lo que genera un modelo es no confiable
Las rutas se validan y el código corre en un contenedor sin root, sin capabilities, con límites de recursos y sin credenciales de la plataforma. Tampoco alcanza la red de las bases de datos. Las vistas previas se sirven con un origen opaco, para que no puedan tocar la API.
Personas en el circuito
Cuando se agotan los reintentos, el grafo se detiene con interrupt() y su estado queda guardado en PostgreSQL. Una persona decide si aprobar, reintentar o abortar, y el sprint continúa justo donde quedó.
Determinismo donde se puede
En el perfil landing, el copy y el diseño llegan como JSON, con un reintento correctivo y un plan B si fallan. Los tokens de diseño se convierten en CSS con código normal, sin pasar otra vez por el modelo.
Un éxito es un Pull Request abierto
Un sprint solo cuenta como exitoso en las métricas DORA si de verdad abrió un PR. Si queda en pausa esperando a una persona, no se reporta hasta que termine.
Cada dato en su lugar
PostgreSQL guarda tareas, auditoría, reportes y checkpoints. Qdrant solo guarda memoria semántica, sin reportes ni capturas, para que los agentes recuerden lo útil y no todo.
El reto
Pedirle a un modelo que genere un proyecto completo de una sola vez deja poco margen para corregir. Yo quería algo más parecido a un equipo de verdad, con roles, entregas pequeñas y pruebas reales. Y quería lograrlo en mi propio equipo, con una sola GPU de 16 GB, donde los modelos no caben juntos y cada decisión cuenta.
Lo que hay detrás
- LangGraph coordina a 14 agentes especializados. Son 11 en el perfil general, de CEO a DevOps, y 3 más en landing, que son Copywriter, Designer y un Visual Critic opcional.
- Todo corre en local con Ollama, en una sola GPU de 16 GB, sin depender de una API externa.
- Cada rebanada sigue TDD y pasa por un build real antes de integrarse al trunk.
- Los reintentos tienen un presupuesto, y en el perfil general los agentes reciben un diagnóstico de los fallos que se repiten.
- El resultado es un repositorio real en Gitea, con un Pull Request para revisarlo.
Decisiones y trade-offs
- Modelos locales en vez de una API cloud. Los 16 GB limitan qué modelos puedo usar y obligan a cargarlos por turnos. A cambio, el código no sale hacia ningún proveedor de modelos y los costos son predecibles.
- Contexto contra velocidad. Un contexto amplio evita que Ollama recorte los prompts, pero hace cada llamada más lenta, y con él el modelo de código más grande ya no cabe entero en la GPU, así que parte se ejecuta en CPU. Es un equilibrio que sigo ajustando.
- Iterar en vez de generar todo de una vez. Hacen falta más pasos, pero cada parte llega probada antes de que empiece la siguiente.
- Una persona revisa después de tres reintentos. El sistema es menos autónomo, pero no se queda dando vueltas en un problema que no puede resolver.
- Observar antes de automatizar. Las métricas y las recomendaciones existen, pero todavía no cambian la configuración por su cuenta. Así cada ajuste sigue teniendo una razón que puedo revisar.