Kurai-Transcribe
Mi propio servicio de transcripción con Whisper, corriendo en mi GPU. Subes un audio y recibes el texto puntuado, con tiempos por palabra y sin mandarlo a ningún proveedor de transcripción.
Lo que ves
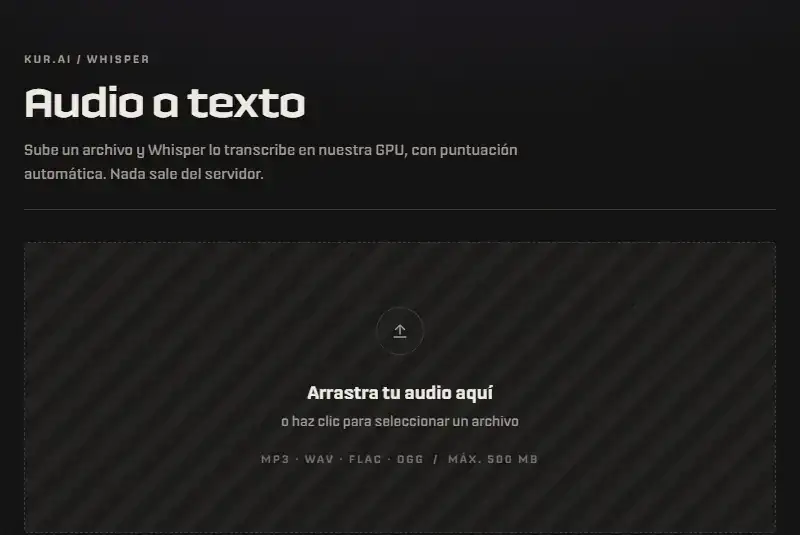
La API es el producto, y esta página pública es la forma más rápida de probarla sin escribir código. Arrastra un audio y Whisper lo transcribe en mi GPU, con la puntuación ya restaurada, listo para copiar o descargar.
Arquitectura
Lo pensé como infraestructura y no como una demo. La inferencia en GPU no tiene magia: es cómputo, memoria y temperatura, así que el servicio cuida los tres y los deja a la vista.
Acceso públicoNGINX y WireGuard
NGINX recibe las peticiones por HTTPS y un túnel WireGuard las lleva hasta mi equipo con GPU, que no queda expuesto directamente.
APIFastAPI
Transcribe en modo síncrono o en segundo plano con un webhook, y ofrece salud del sistema y métricas en sus propios endpoints.
Preparación del audiopydub y ffmpeg
Valida cada archivo antes de que llegue a la GPU y convierte formatos como el OGG Opus de las notas de voz de WhatsApp.
InferenciaFaster-Whisper
Corre large-v3 sobre CTranslate2 en float16, con filtrado de voz (VAD) y tiempos a nivel de palabra.
PuntuaciónTransformers
Un modelo restaura la puntuación del texto, con un respaldo por reglas si no está disponible.
- NVIDIA CUDAInferencia acelerada por GPU
- NVMLLectura de VRAM, uso y temperatura
- PrometheusMétricas del servicio y de la GPU
- WebhooksEntrega de los trabajos asíncronos
Una sola inferencia a la vez en la GPU
Un semáforo protege la GPU para evitar la fragmentación de VRAM y las inferencias en paralelo inestables. Las peticiones esperan su turno en vez de competir por la memoria y tumbar el servicio.
El modelo se carga una vez
Whisper se carga al arrancar y se queda residente en VRAM, así ninguna petición paga el tiempo de cargarlo.
No esconder el estado del sistema
El endpoint de salud y las métricas muestran VRAM, temperatura, uso de GPU, latencia, tasa de error y velocidad frente al tiempo real. Si algo va mal, se puede ver por qué.
Dos formas de pedir lo mismo
Para un audio corto, la API responde en la misma petición. Para uno largo, responde de inmediato y entrega el resultado a un webhook, sin dejar a nadie con la conexión abierta.
Fallar rápido y con claridad
Los archivos que no sirven se rechazan antes de ocupar la GPU, y los errores vuelven como JSON claro.
El reto
Tener transcripción de calidad sin mandar el audio a un proveedor de transcripción. Eso significa controlar los datos y el modelo en hardware propio, sin que la memoria de la GPU tumbe el servicio y sabiendo siempre qué está pasando dentro.
Lo que hay detrás
- El servicio no depende de ningún SaaS externo para transcribir.
- La respuesta incluye el idioma, el texto completo, los tiempos por palabra, la latencia y la velocidad de esa transcripción.
- La página web es solo un cliente de la API, con arrastrar y soltar, y opciones para copiar y descargar.
- Corre como un servicio de Linux en mi propio equipo, con scripts para instalarlo y arrancarlo.
Decisiones y trade-offs
- Primero la API. La web es solo un cliente más, así que otra aplicación puede integrarse sin cambiar el motor.
- Hardware propio en vez de un proveedor externo. Gano control sobre los datos y el modelo, y a cambio la memoria y la disponibilidad son responsabilidad mía.
- Una inferencia a la vez. Se atienden menos peticiones en paralelo, pero el servicio se mantiene estable en una sola GPU.
- Modelo siempre residente. Ocupa VRAM aunque no haya trabajo, a cambio de que cada petición empiece sin esperar la carga.