GenRuntime
Un estudio de video local para una sola GPU de 16 GB. Le das un JSON que describe el plano y te devuelve un clip que ya pasó control de calidad, con una persona que aprueba los keyframes antes de gastar GPU en el video.
Lo que ves
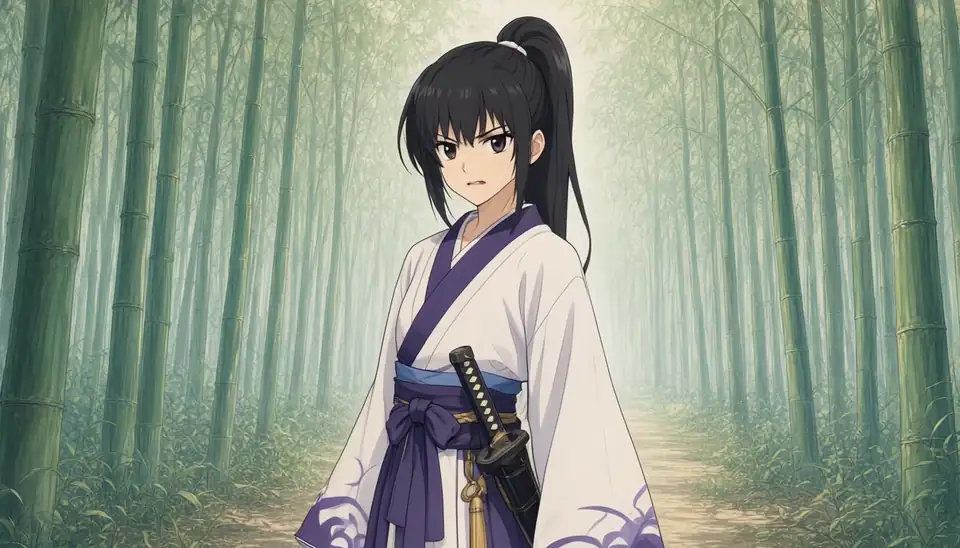
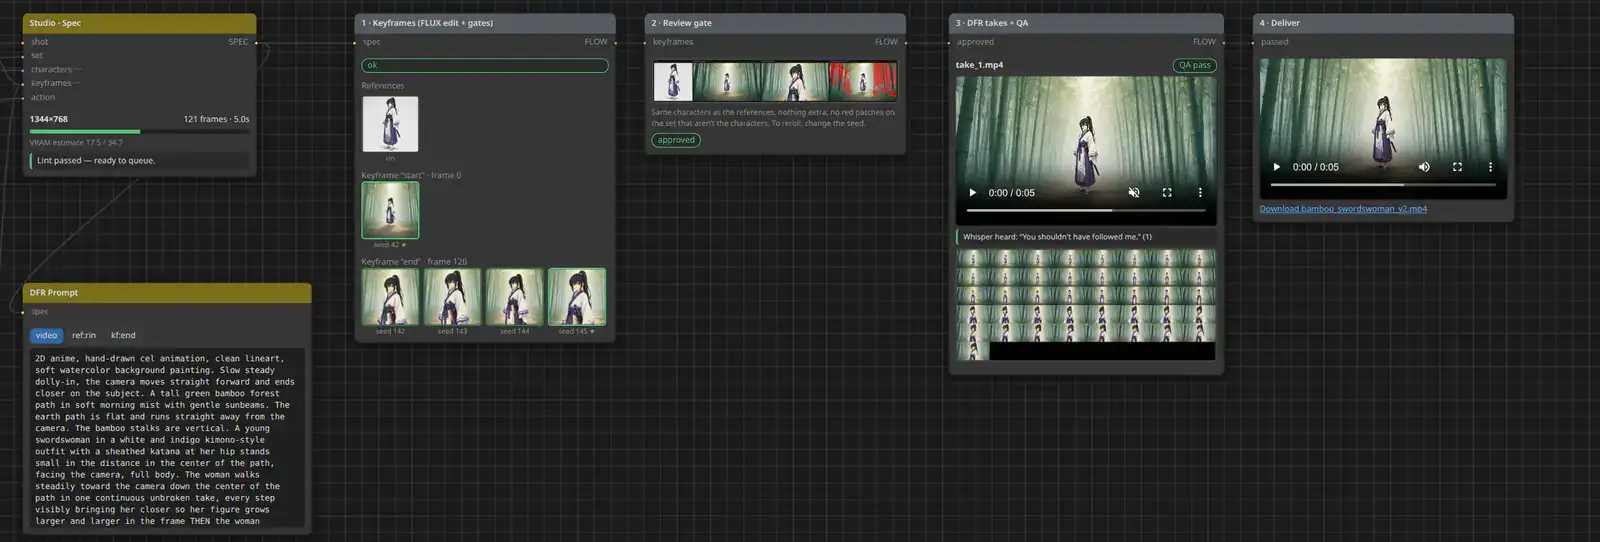
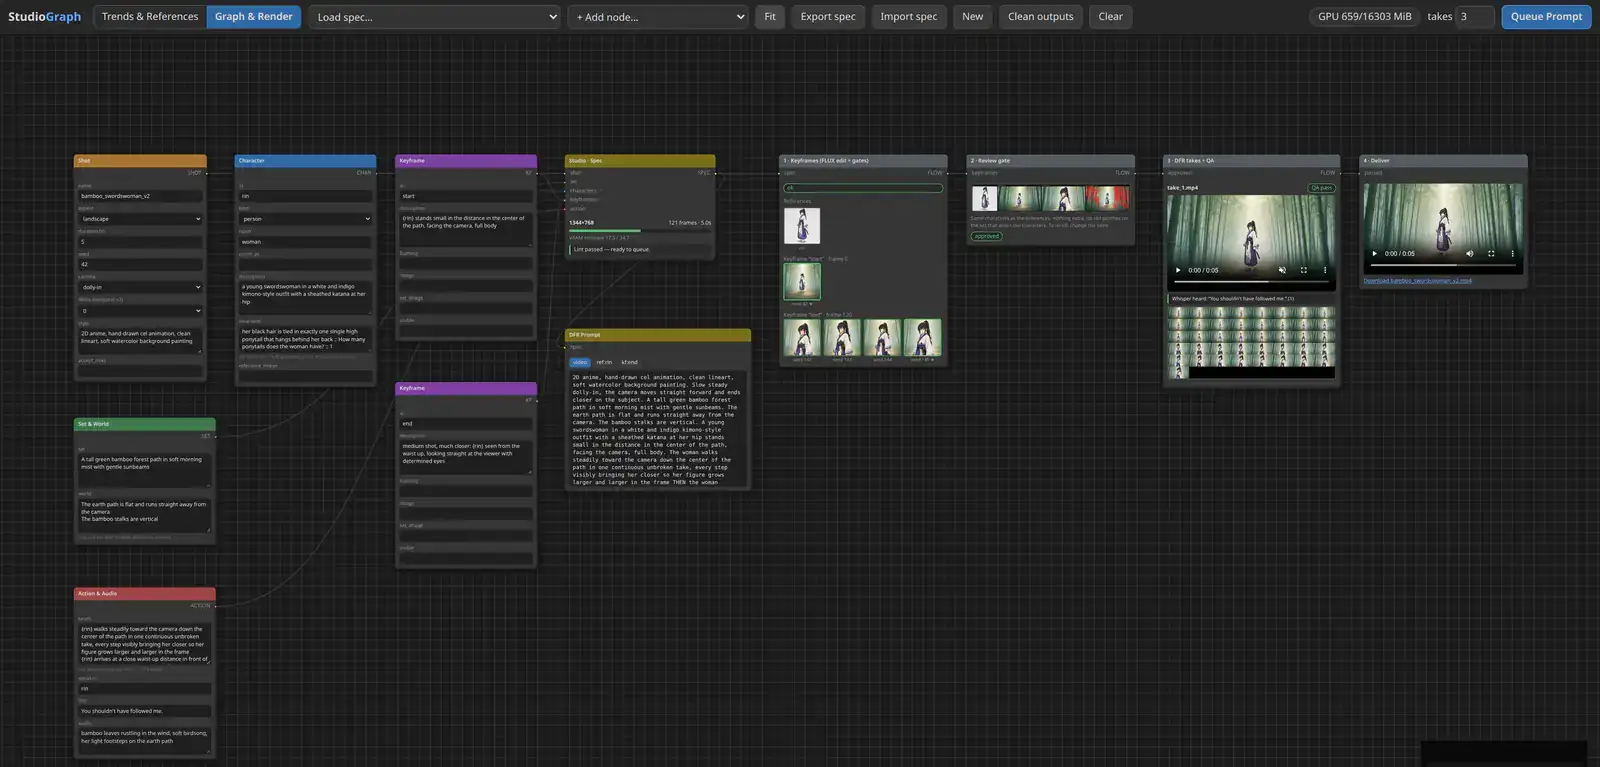
Una toma real de principio a fin, con una espadachina caminando por un bosque de bambú. El grafo muestra la spec, los keyframes, la revisión, el video con su QA y el clip listo para descargar.
Clips generados con IA
Dale play: todos traen sonido.
00:00 / 00:36
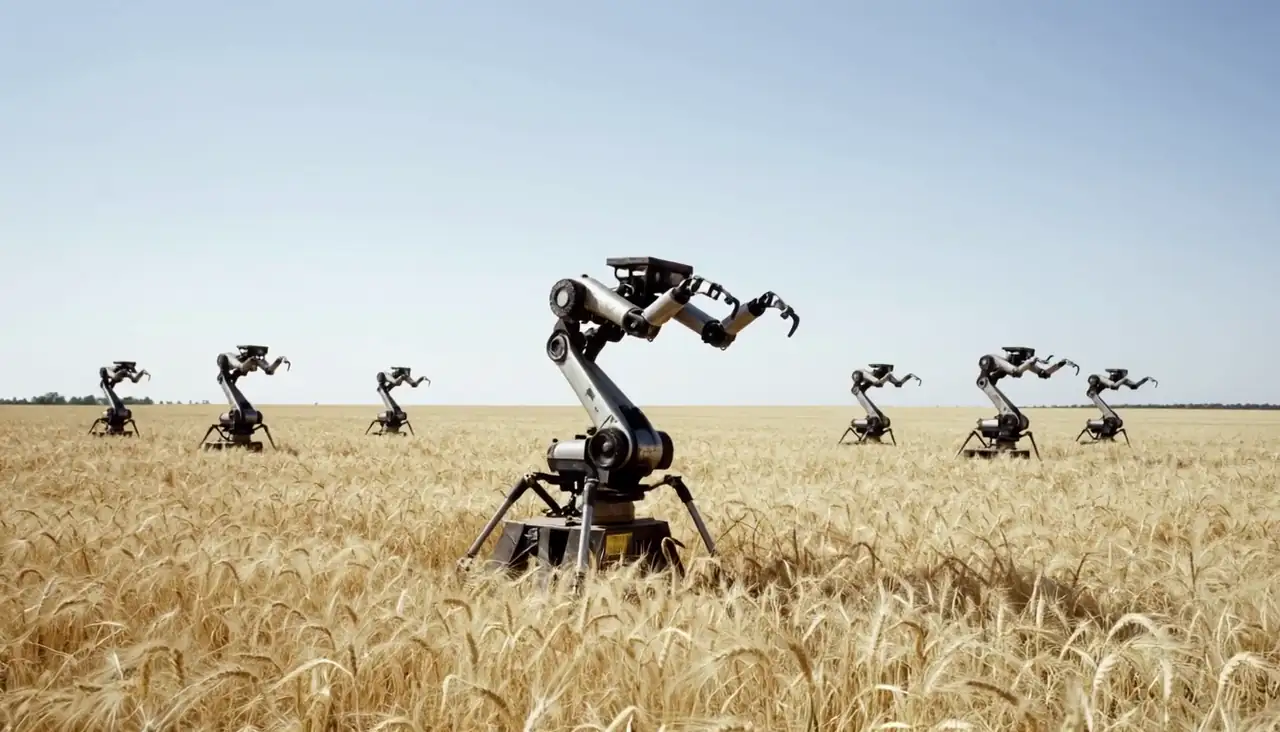
El silencio de los autómatas
Un corto en un campo de trigo, donde cada vez aparecen más máquinas.
00:00 / 00:14
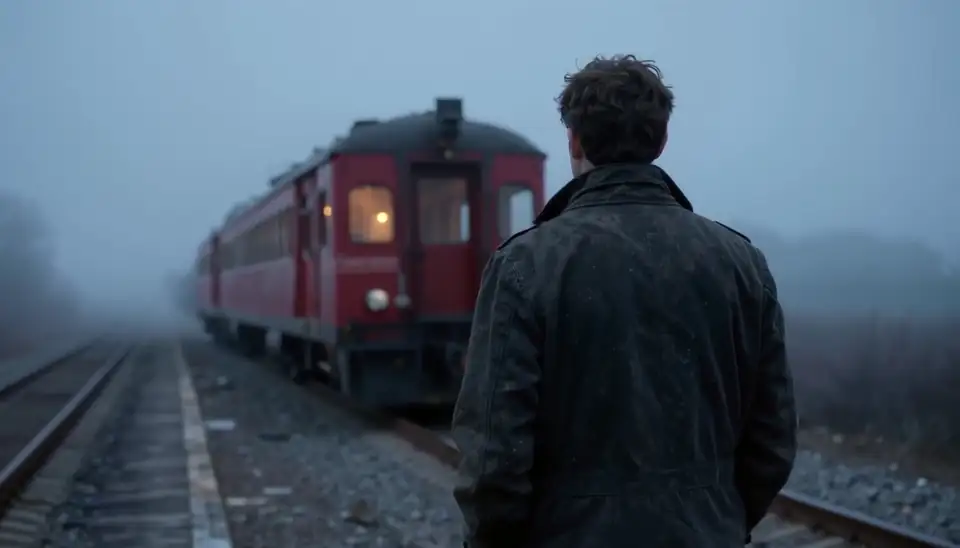
Andén en la niebla
Un tren rojo llega entre la bruma y pasa junto a alguien que lo espera de espaldas.
00:00 / 00:05
Espadachina de bambú
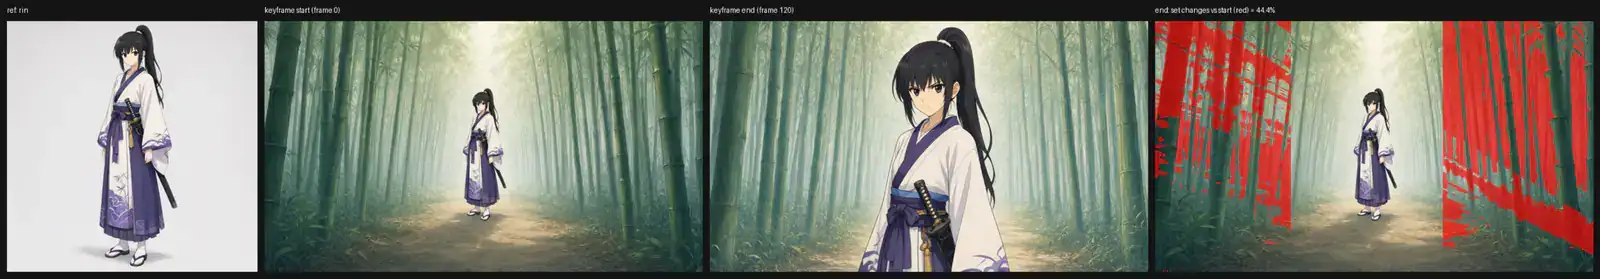
La toma que ves en las capturas de abajo: camina hacia la cámara y dice su línea.
00:00 / 00:06
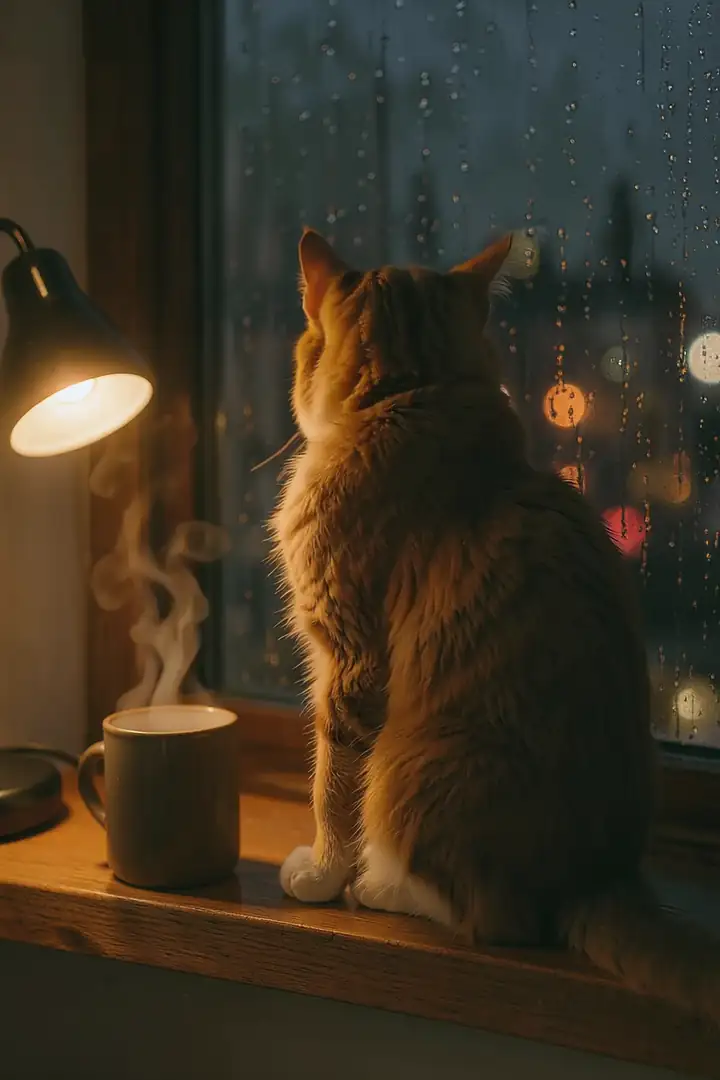
Gato lofi
Lluvia en la ventana, una taza humeante y un gato que mira pasar la noche.
00:00 / 00:05
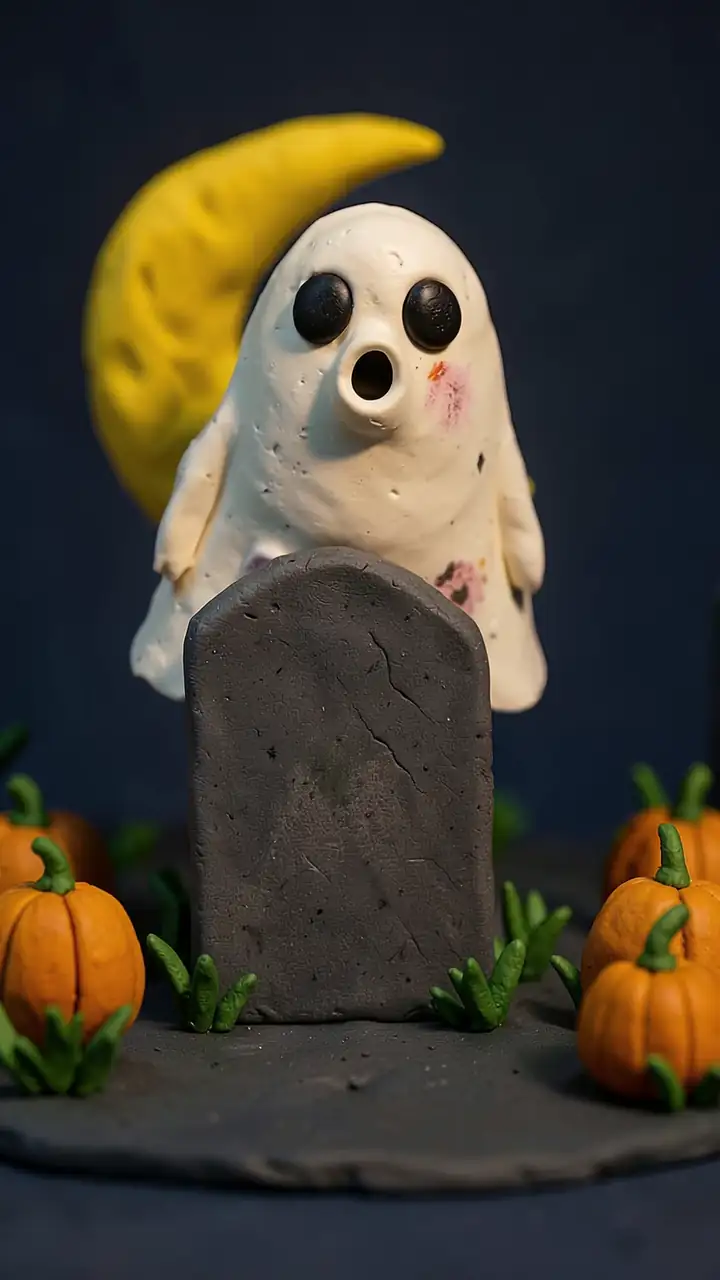
Fantasma de plastilina
Un fantasma se asoma detrás de la lápida, con textura de plastilina.
00:00 / 00:07
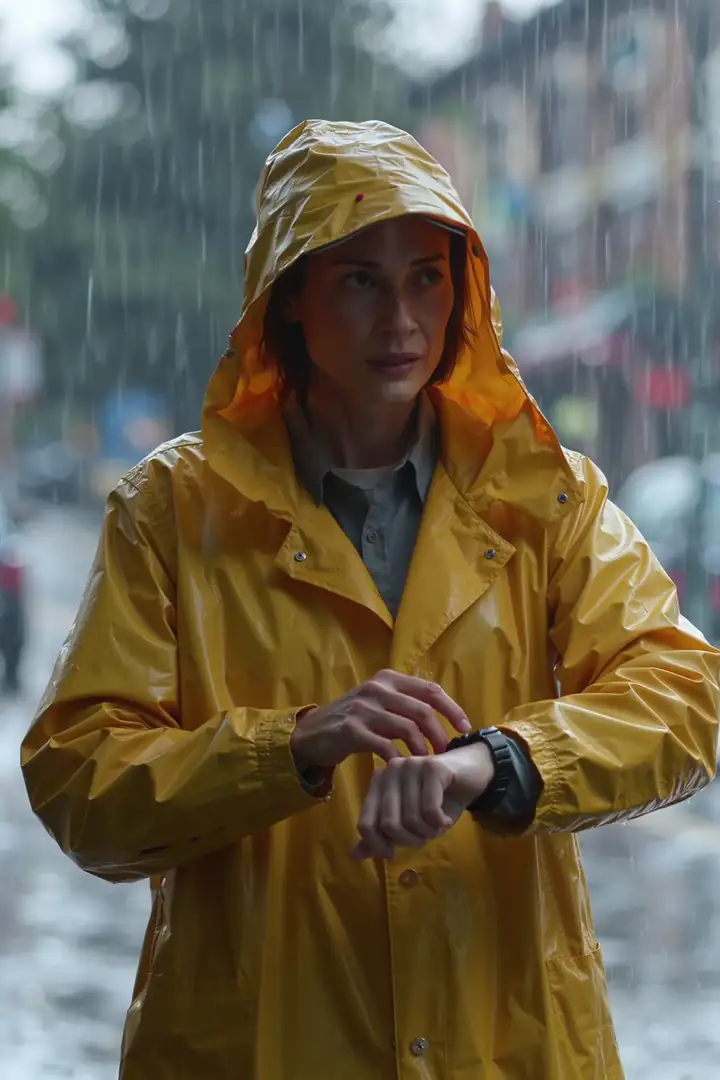
Bajo la lluvia
Un impermeable amarillo, una calle mojada y una mirada al reloj.
Cómo fluye
- Spec en JSON
- Linter
- Keyframes con FLUX.2
- Aprobación humana
- Video con LTX-2.5
- QA y clip final
Arquitectura
GenRuntime no es un solo programa. Son dos contenedores con dependencias que no pueden convivir, un host que los coordina y un estado en disco que permite retomar cada plano donde quedó. En una sola GPU de 16 GB cada corrida cuenta, así que el sistema evita repetir lo que no hace falta.
Spec y linterPython
Cada plano es un JSON. El linter bloquea fallas que ya conocemos, como el presupuesto de VRAM, los tiempos de diálogo, las manos, los fundidos y los saltos de cuadrúpedos, antes de tocar la GPU.
KeyframesFLUX.2 klein
Genera candidatos por keyframe y los filtra con el conteo de personajes, invariantes de diseño, localización con OWLv2 y la cámara por geometría. Gana el candidato que menos cambia el fondo.
Revisión humanaHost
El pipeline se detiene en review.png hasta que alguien aprueba. La aprobación queda ligada al hash de la spec, así que no sirve para otra versión.
Video y audioLTX-2.5 DFR
Renderiza el take con el stack de Lightricks en su propio contenedor. Cada corrida deja un registro con el comando, los tiempos y el pico real de VRAM.
Control de calidadVLM, DINOv2, Whisper
Revisa contenido, cámara, parecido con los keyframes y diálogo. Un take se entrega solo si pasa todos los chequeos. Si falla, se reintenta con otra seed.
- DockerDos imágenes con dependencias aisladas
- OllamaModelo de visión para preguntas sobre un frame
- OWLv2 y DINOv2Localizar personajes y medir similitud
- WhisperTranscribe el diálogo para verificarlo
- React FlowEl grafo de la interfaz es la misma spec que consume el pipeline
Varios procesos, no uno
Los dos contenedores fijan versiones incompatibles de torch y de los modelos. El host coordina y los contenedores hacen el trabajo de GPU, así que ninguna dependencia le pelea a otra.
El estado vive en disco
output/studio/<nombre>/ guarda el avance. Repetir run continúa donde quedó, y si cambia la spec se borra solo lo que dependía de ella.
Reglas nacidas de fallas reales
Cada regla del linter y cada umbral de QA responde a una falla que ocurrió, no a una intuición. Por eso los umbrales son concretos, como una similitud de 0.80 con los keyframes.
Medir antes de opinar
Cada veredicto de QA se apoya en una medición, como la homografía del fondo con los sujetos enmascarados, la similitud DINOv2 o la transcripción de Whisper. El VLM solo responde preguntas simples sobre un frame.
Reintentar con criterio
Un fallo de QA no siempre es mala suerte. El runner experimental clasifica cada falla, y vuelve a tirar la seed solo cuando la falla parece aleatoria, y aborta cuando el problema está en la spec.
Cómo está armado
Mapa del sistema
Tres entornos, cada uno con su propio stack. El host decide qué hacer y los contenedores hacen el trabajo de GPU.
Host
- studio: núcleo del pipeline
- lab: runner experimental
- Interfaz de grafo
- Estado en disco
docker run · keyframes y QA
Contenedor app
- FLUX.2: keyframes
- QA de video con OWLv2 y DINOv2
- Pruebas sin GPU
docker run · takes de video
Contenedor ltx25-dfr
- LTX-2.5 DFR
- Código de Lightricks, sin modificar
- OllamaModelo de visión (VLM) para preguntas sobre un frame
- WhisperTranscribe el diálogo para verificarlo
- GPUUna sola de 16 GB, un trabajo a la vez
Un plano, de punta a punta
Cada etapa deja una salida que se puede revisar. La puerta de aprobación es la única que espera a una persona.
- Spec JSONDescribe personajes, escenario, acción, cámara y diálogo.
- LinterBloquea fallas conocidas antes de usar la GPU.
- KeyframesFLUX.2 genera candidatos y los filtra por conteo de personajes, invariantes, localización y cámara.
- Puerta humanaSe detiene en review.png hasta que alguien aprueba. La aprobación depende del hash de la spec.
- Take de videoLTX-2.5 DFR renderiza video y audio en su propio contenedor.
- QARevisa contenido, cámara, parecido con los keyframes (DINOv2) y el diálogo (Whisper).
- Entregaoutput/<nombre>.mp4 y su reporte, solo si el take pasó todos los chequeos.
Si el QA falla, se reintenta con otra seed (+1000), hasta tres intentos por defecto.
Qué hacer con cada falla
El runner experimental no reintenta todo igual. Cada tipo de falla tiene una acción distinta.
PASSEntrega el clip.QA_SUSPECTRevisa el mismo take en tres frames vecinos antes de decidir.STOCHASTICLa falla parece aleatoria: prueba otra seed.INFRAEs del entorno, no del plano: reintenta la misma seed una vez.STRUCTURALEl problema está en la spec: aborta y corrígela.
Lo que queda en disco
El avance vive en carpetas, no en la memoria. Repetir run continúa donde quedó, y si cambia la spec se borra solo lo que dependía de ella.
output/studio/<nombre>/
- spec.jsonLa versión vigente del plano
- keyframesCandidatos, con el elegido marcado
- review.pngLo que la persona revisa antes del video
- APPROVEDHash de la spec aprobada; no vale para otra versión
- takesCada intento con su seed y su registro
output/<nombre>.mp4 + _report.jsonSolo aparece si el take pasó todo el QA.
El reto
Generar video en una sola GPU de 16 GB deja poco margen, y un plano malo suele notarse tarde, cuando el render ya gastó su tiempo. El reto fue llegar de una descripción a un clip confiable en mi propio equipo, con puntos de control antes de gastar GPU en video, y con un sistema que explique por qué falló lo que falló.
Lo que hay detrás
- Cada plano empieza como un JSON que pasa por un linter antes de tocar la GPU.
- FLUX.2 genera candidatos de keyframe y los filtra con visión por computadora. Los personajes se guardan como referencias para mantener su identidad entre planos.
- Una persona aprueba los keyframes. Solo después el video se renderiza.
- LTX-2.5 genera video y audio dentro de su propio contenedor, sin modificar su código.
- El control de calidad combina modelos especializados. Cada uno mide una cosa, y el VLM solo responde preguntas simples sobre un frame.
- Una interfaz de grafo muestra cada etapa. El grafo es la spec, así que lo que se dibuja se compila al mismo JSON que consume el pipeline.
- El runner experimental para varios planos predice VRAM y tiempo, y clasifica las fallas para decidir si reintentar o abortar.
Decisiones y trade-offs
- Una persona aprueba antes del video. Frena el flujo, pero evita gastar una corrida de video en keyframes que ya se ven mal.
- Dos imágenes de Docker en vez de una. Hay más que mantener, pero las dependencias de cada parte entran en conflicto y así cada una conserva las suyas.
- Todo en local en vez de una API en la nube. El límite de 16 GB condiciona cada elección de modelo, y a cambio no dependo de un proveedor.
- El runner multi-plano es experimental. Ahorra GPU en lotes, pero todavía no es el flujo principal, así que no lo presento como tal.